WordPressの公式AIプラグインで、Embedding(エンベディング)と意味検索の土台づくりが進んでいます。2026年9月18日に公開されたWordPress 7.2のロードマップにも、「Embeddings and semantic search」がはっきり書かれました。文章を書くAIや画像を作るAIのように目立つ機能ではありませんが、サイトに溜まった記事を「AIが意味で理解して探せる」ようにするための、地味で大事な基盤です。
当社はこれまでAIチャットボットを3つ作ってきました。1つ目は、外部のベクトルデータベース「Pinecone」を使ってゼロから自作したものです。一方で、ベクトルデータベースを使わず、WordPressのデータベースにEmbeddingを保存する方式で作ったこともあります。その経験から気になるのは、「公式がこの仕組みを標準で用意すると、何が変わるのか」「Pineconeのような外部サービスはいらなくなるのか」という点です。この記事では、公式の情報でいまどこまで進んでいるかを整理し、公開されている開発版のコードを使って、何件までなら実用的かを実際に測りました。
結論から言うと、WordPressのデータベースだけでRAG型のチャットボットを作ることは、自作すれば今でもできます。2026年9月時点でまだできないのは、公式AIプラグインの機能だけで作ることです。公式はその土台の半分を作り終えたところで、数百〜千件程度の小さなサイトなら、外部のベクトルデータベースなしで意味検索が回る見込みです。一方で、公式チーム自身が「専用のベクトルデータベースに比べてスケールに限界がある」と認めていて、件数が増えるとレンタルサーバーのメモリ上限に先に届きます。
この記事は2026年9月23日時点の公式情報と、同日に取得した開発版コードでの実測にもとづいています。AIプラグインは開発中で、仕様は変わる可能性があります。新しいリリースが出たら追記します。
何が起きているのか|7.2ロードマップに「Embeddingと意味検索」
7.2のロードマップでは、AI関連の項目として次のように書かれています。
「AIプラグインの中に、共通のEmbedding機能(生成・保存・バックグラウンドでの同期)を作り、意味にもとづく検索と、サイトの内容にもとづく応答を実現する」(原文を当社で要約)
ここで大事なのは、場所がWordPress本体ではなく「AIプラグイン」だという点です。ロードマップには「7.1の開発サイクルで、AI機能は実際に使われて価値が示されてから本体に入れる、という方針が明確になった。以下の作業は7.2に入る保証なしにAIプラグインで進める」と明記されています。AIチームの週報でも「近いうちに本体へ統合することは想定していない」と書かれています。つまり、WordPress 7.2に更新すれば意味検索が使えるようになる、という話ではありません。
2026年9月23日時点で、どこまで進んでいるかを整理すると次のとおりです。
| 部品 | 状況 |
|---|---|
| Embeddingを作る仕組み(PHP AI Client) | リリース済み(1.4.0で追加、1.5.0でモデル指定が必須に) |
| Embeddingを保存する専用テーブル | 開発版にマージ済み(9月2日)。リリース版には未搭載 |
| 似ている度合いの計算 | 開発版にマージ済み(9月14日)。リリース版には未搭載 |
| 投稿を自動でEmbeddingし直す仕組み | 提案(プルリクエスト)段階、レビュー前 |
| 管理画面の意味検索 | 提案段階 |
| サイトの内容で答えるチャット(RAG) | 将来の構想(Future Release) |
AIプラグインの最新リリースは8月18日の1.3.0で、上の「開発版にマージ済み」の2つはまだ入っていません。次のリリースは「9月後半」の予定とされています。
Embeddingとは?意味検索とは?
Embeddingは、文章の意味を数字の並び(ベクトル)に変換したものです。たとえるなら、すべての文章に「意味の住所」を付けるようなものです。意味の近い文章は近い住所に、遠い文章は遠い住所になります。住所の数字は、使うAIのモデルによって768個や1536個といった長さになります。この長さを「次元」と呼びます。
意味検索(Semantic Search)は、この住所の近さで記事を探す検索です。質問文にも住所を付けて、近くにある記事を拾ってきます。
WordPressの通常の検索との違い
WordPressの標準の検索は、入力した言葉がそのまま含まれている記事を探します。そのため、「サイトが表示されない」と検索しても、「真っ白になった」と書かれた記事は見つかりません。意味検索なら、言葉が違っても意味が近ければ見つけられます。サイト内検索で「探している記事があるのに出てこない」という問題を減らせるのが、一番分かりやすい効果です。
公式はどう作ろうとしているのか
開発版にマージされたコードと公式の文書から、設計のポイントを4つ挙げます。
- 保存先は専用のテーブル。投稿のメタ情報(postmeta)ではなく、wpai_embeddings という専用テーブルに保存します。1つの投稿を複数に分けて保存できる作りです。
- 検索はPHPで全件と比べる。データベースの機能で探すのではなく、保存したベクトルを読み出して、PHPで1件ずつ似ている度合い(コサイン類似度)を計算し、上位を返します。
- 記事が変わったときだけ作り直す。内容の指紋(ハッシュ)を比べて、変わっていなければAIに問い合わせません。費用を抑える工夫です。
- モデルを変えたら全件作り直し。違うモデルで作った住所どうしは比べられないため、保存するときにモデル名と次元を記録しています。
保存形式は、MariaDBのベクトル型と同じバイトの並びにしてあり、将来データベース側の高速な検索に差し替えられるよう配慮されています。ただし、その差し替え(MariaDB 11.8以降のベクトル索引を使う案)はまだ下書き段階です。MySQLの無料版(Community)には、ベクトルどうしの距離を計算する関数が入っていないことも、公式の文書で確認できます。
Pineconeで作ってきた立場から見て
当社がこれまで作ったチャットボットは3つです。1つ目はPineconeを使ってゼロから自作し、2つ目は開発プラットフォームのDifyを使い、3つ目が現在のEdel AI Hybrid Chatです。1つ目を作ったときのことはチャットボット自作の現実に詳しく書きましたが、開発期間3週間のうち最も時間を食ったのは、Pineconeそのものではなく「資料をどう分けて取り込むか」でした。
資料を章で区切るか、段落で区切るか、何文字で区切るか。大きく切れば文脈は保てるが検索が粗くなり、細かく切れば検索は当たるが前後の文脈が切れて回答が浅くなる。この調整をひたすら繰り返しました。もう1つ大変だったのが、資料を更新したときに、ベクトルデータベースの中身を追いつかせることです。
この目で公式の計画を見ると、興味深いことが分かります。保存と計算という「Pineconeが担っていた部分」は、WordPressの中で先にできつつあります。一方で、私が一番苦労した「どう分けるか」と「更新にどう追いつくか」は、公式でもまだ決まっていません。保存の仕組みは分割に対応していますが、分け方の方針は未決定で、試験用のコマンドが750文字ずつ区切っているだけです。自動同期の提案も、いまは1記事を1つのベクトルとして扱う設計です。
なお、外部のベクトルデータベースは必須ではありません。当社は、ベクトルデータベースを使わず、OpenAIなどでEmbeddingを作り、WordPressのデータベースに保存して、PHPで似ている度合いを計算する方式でもチャットボットを作ったことがあります。この記事の後半で測っているのも、まさにこの方式の計算時間です。
では、公式が作ると何が変わるのか。いまは、自作する人やプラグインごとに、保存するテーブルも、分け方も、更新の追いかけ方もバラバラです。公式の保存層を追加したプルリクエストにも、「実験中の各機能がそれぞれ独自の保存先を持っていたものを、共通の基盤にまとめる」という趣旨が書かれています。共通の土台ができれば、サイト内検索・関連記事・チャットボットが同じEmbeddingを使い回せるようになり、AIの提供元を切り替えるときも作り直す範囲が小さくなります。「作れるようになる」のではなく、「誰もが同じ部品で作れるようになる」という変化です。
つまり、外部サービスが不要になっても、チャットボットづくりの一番難しいところが消えるわけではありません。むしろ、そこが公式の仕組みの上で標準化されていくかどうかが、今後の見どころだと思います。
実測:何件までならWordPressだけで足りるのか
「PHPで全件と比べる」設計だと、件数が増えるほど遅くなります。どのくらいで限界が来るのかを確かめるため、公開されている開発版のコード(似ている度合いの計算部分)をそのまま使って測りました。中身は乱数のベクトルですが、長さと保存形式は本物と同じです。1536次元はOpenAIの text-embedding-3-small、768次元はオープンなモデルの nomic-embed-text と同じ長さです。
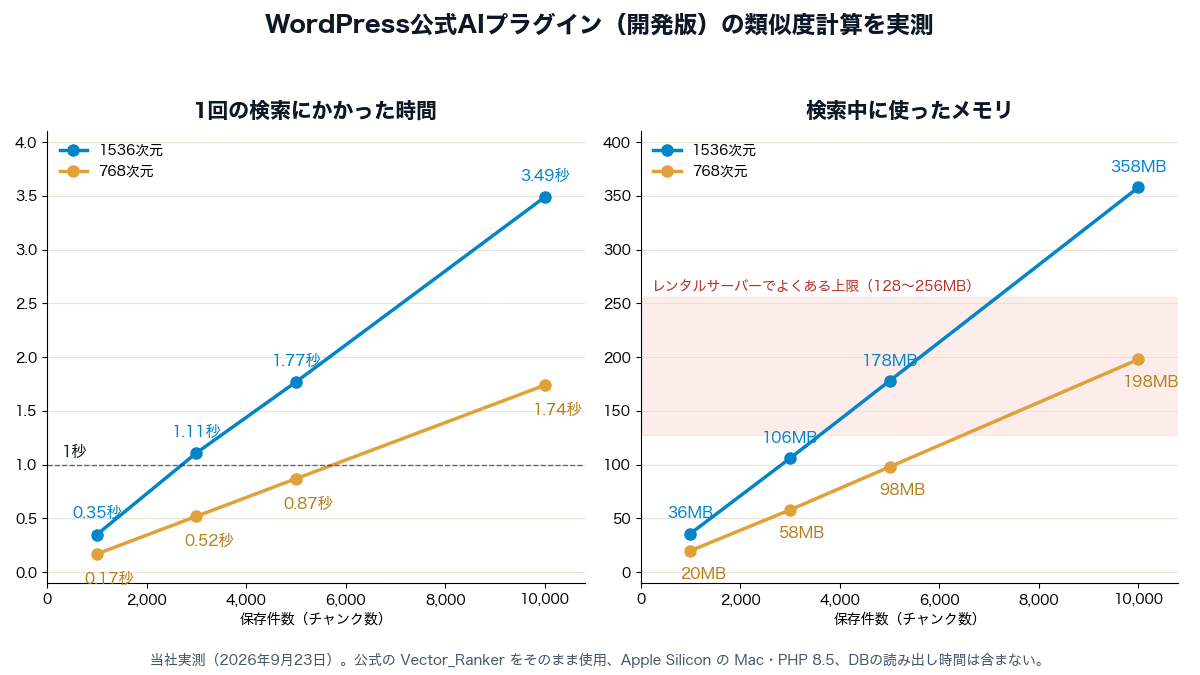
| 保存件数 | 1536次元 時間 | 1536次元 メモリ | 768次元 時間 | 768次元 メモリ |
|---|---|---|---|---|
| 1,000件 | 0.35秒 | 36MB | 0.17秒 | 20MB |
| 3,000件 | 1.11秒 | 106MB | 0.52秒 | 58MB |
| 5,000件 | 1.77秒 | 178MB | 0.87秒 | 98MB |
| 10,000件 | 3.49秒 | 358MB | 1.74秒 | 198MB |
測定条件: Apple SiliconのMac、PHP 8.5、3回測った中央値。データベースから読み出す時間は含んでいません。一般的なレンタルサーバーでは、これより遅くなると考えてください。
時間もメモリも、件数にほぼ比例して増えました。全件と比べる方式なので、当然の結果です。ここから読み取れることは3つあります。
- 1秒以内に収まるのは、1536次元で約3,000件まで。768次元なら約6,000件までです。チャットの返事を待てる時間を1秒と考えた場合の目安です。
- 先に効くのはメモリ。レンタルサーバーでよくあるPHPのメモリ上限(128〜256MB)に、1536次元では約3,500〜7,000件で届きます。
- 数えるのは「記事数」ではなく「分けた後の件数」。記事を750文字ずつに分けて保存すると、3,000字の記事は約5件になります。1536次元で1秒以内という目安は、記事に直すと600本前後です。
3つ目は見落としやすい点です。「うちは記事が500本だから大丈夫」と思っても、分割の仕方しだいで保存件数は数倍になります。なお、現在の計算部分は候補を一度にまとめて受け取る作りです。最終的な検索機能で、少しずつ読み込む工夫や、保存済みの「粗い住所(二値化したベクトル)」で先に絞り込む仕組みが入れば、この数字は改善する可能性があります。
Pineconeなど外部のベクトルデータベースは不要になるのか
公式の設計と実測をあわせると、規模によって答えが変わります。
| サイトの規模 | WordPressだけで足りるか |
|---|---|
| 記事が数十〜数百本 | 足りる見込みが高い。外部サービスの契約や同期の手間がなくなる利点が大きい |
| 記事が数百〜千本程度 | 分割の仕方とモデルの次元しだい。768次元のモデルを選ぶと余裕が出る |
| 記事が数千本以上、商品が数万点 | 現在の設計のままでは厳しい。データベース側の索引(MariaDBのベクトル索引など)か、外部のベクトルデータベースが必要になる見込み |
公式チーム自身も、週報で「PHPやデータベースでの類似度計算は、専用のベクトルデータベースと比べてスケールに限界がある」と認めています。外部サービスを置き換えると宣言しているわけではなく、まずはシンプルにWordPressの中に置き、保存先は後から差し替えられるようにするという方針です。小さなサイトでは外部サービスがいらなくなり、大きなサイトでは引き続き使う、という棲み分けになると考えるのが自然です。
「Embedding対応」は「RAG搭載」ではない
ここは誤解が生まれやすいので、はっきり書いておきます。公式AIプラグインにEmbeddingが入っても、それだけでRAGのチャットボットになるわけではありません。サイトの内容をもとにAIが答えるRAGには、次の工程がすべて必要です。
- 資料を適切な大きさに分ける
- 分けたものをEmbeddingにして保存する
- 質問に近いものを探す
- 見つけたものを整理してAIに渡す
- AIが回答を作る
- 答えられないときの振る舞いを決める
自作する場合は、この6つを全部自分で作ることになります。いま公式が作っているのは、主に2と3の土台です。1の分け方は未決定で、4〜6はチャットボットの構想(Future Release)の中にあります。当社が3つのチャットボットを通して最後まで手を焼いたのも、6の「答えられないときに嘘をつかせない」部分でした。この工程は、基盤が整っても自動では解決しません。
この基盤ができると、WordPressの何が変わるか
ここからは当社の見立てです。Embeddingの保存と検索がWordPressの共通機能になると、次のような機能が同じ土台の上に作れるようになります。
- 言葉が違っても見つかるサイト内検索
- 意味の近い関連記事の自動表示
- WooCommerceでの「この商品を見た人に近い商品」の提案
- 管理画面で「去年書いた料金の記事どれだっけ」と自然な言葉で探す機能
- サイトの内容をもとに答えるAIチャットボット
- AIエージェントがサイトの情報を正確に取りに来るための窓口
WordPressのAI対応は、「AIで文章を書くCMS」から、「サイトに溜まったデータをAIが理解して使えるCMS」へ進み始めているように見えます。ただし、それが本体の標準機能になるのは、プラグインで使われて価値が示されてからです。
よくある質問
Q. いまWordPressだけでRAGのチャットボットは作れますか?
自作すれば作れます。OpenAIなどでEmbeddingを作り、WordPressのデータベースに保存して、PHPで似ている度合いを計算する方式です。外部のベクトルデータベースは必須ではありません。まだできないのは、公式AIプラグインの機能だけで作ることです。
Q. WordPress 7.2に更新すれば、意味検索が使えますか?
使えません。Embeddingと意味検索はAIプラグインで開発されていて、ロードマップにも「7.2に入る保証はない」と明記されています。
Q. いまAIプラグインを入れれば試せますか?
2026年9月23日時点のリリース版(1.3.0)には、保存と検索の部分がまだ入っていません。開発版には入っていますが、試験段階のため本番サイトでの利用はおすすめしません。
Q. 記事が何本くらいまでならWordPressだけで大丈夫ですか?
当社の実測では、1536次元のモデルで1回の検索を1秒以内に収めるなら、分割後の件数で約3,000件まででした。記事を750文字ずつに分ける場合、記事数では600本前後が目安です。レンタルサーバーでは読み出し時間とメモリ上限が加わるため、もっと少なく見積もってください。
Q. すでにPineconeなどで作ったチャットボットは作り直すべきですか?
急ぐ必要はありません。公式の仕組みはまだリリース前で、分け方や同期の方針も決まっていません。記事数が少なく、外部サービスの費用や同期の手間が負担になっている場合は、正式リリース後に移行を検討する価値があります。
公式の基盤を待たずに、いま自社サイトで試すなら
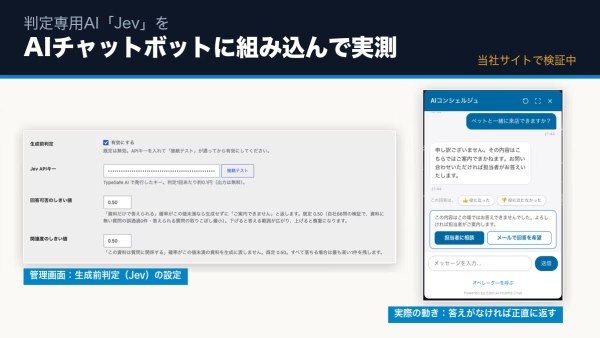
「サイトの内容をもとに、出典付きで答えるAIチャット」は、公式の基盤が整うのを待たなくても、すでに実現できます。当社のEdel AI Hybrid Chatは、3つのチャットボットを作ってきた経験をもとに、分割・検索・答えられないときの振る舞いまで作り込んだWordPress専用のAIチャットです。
貴社サイトのURLとメールアドレスを入れるだけで、公開ページを読み込んだ貴社専用のAIチャットの体験ページを数分で自動作成します。出典リンク付きで答え、書かれていないことは「記載がありません」と正直に答えます。費用はかからず、売り込みもしません。
▶ 貴社サイト専用のAIチャットを無料で作ってみる(入力はURLとメールだけ)
更新履歴
- 2026年9月26日:公開(2026年9月23日時点の公式情報と開発版コードでの実測)
この記事を書いた人
矢部 敦合同会社Edel Hearts 代表
WordPress専門の開発会社を経営。プラグイン開発・カスタマイズ・保守を専門とし、18時間におよぶUdemyのWordPress講座を開講。出典付きで回答するAIチャットボット「Edel AI Hybrid Chat」開発者。著書『WordPress はじめての最小プラグイン』(Kindle)。本ブログの記事は、実際の開発・運用で得た一次情報をもとに執筆しています。会社情報はこちら